用 LLM-Wiki 与 OKF 工程化构建第二脑 Ghost
基于 Andrej Karpathy LLM-Wiki 规范与 OKF 标准,从 RAG 检索拼凑转向编译优先的个人第二大脑架构实践。
用 LLM-Wiki 与 OKF 工程化构建第二脑 Ghost#
核心导读:
传统的个人笔记往往陷入“只囤积未消化的原始素材、手工打理过载、碎片孤立无脉络”的死循环,最终沦为吃灰的资料堆。本文基于 Ghost 系统在千篇规模下的真实工程实践,拆解如何将 Andrej Karpathy 的 LLM-Wiki 自治编译设想与 Google 的 OKF 强类型工程规范深度结合:通过物理底座只读、正文散列寻址、目录白名单隔离与输出专属解耦,工程化构建一套真正能自治演进、让沉淀持续转化为高质量产出的第二脑。
一、 不用 AI 的个人知识库,为什么注定吃灰?#
几乎每个追求深度思考与持续积累的人,都曾试图维护一套属于自己的个人知识管理系统(Personal Knowledge Management,简称 PKM)。从早期的 Evernote、Notion,再到基于本地纯文本的双链笔记。
然而,在不借助大模型能力的传统纯手工模式下,绝大多数人的知识库在经历两三个月的热情期后,都会不可避免地走向停摆与“吃灰”:
-
“信息的搬运工”陷阱:收藏 ≠ 学会,囤积 ≠ 拥有
过去习惯了将外部看到的好文章、深度报告、音视频转录稿“一键剪藏”进自己的笔记软件。然而,存进来的全都是未经消化的原始素材。把别人的文字原封不动地塞在本地文件夹里,并不代表它们进入了自己的知识体系。大量的“生肉”素材原样堆在磁盘里,本质上只是建了一座数字垃圾堆,没有任何知识密度可言。 -
维护成本的断崖式过载:手工打理费时费力,难以持续
既然原始素材没法直接用,就只能靠人工手动处理:逐篇精读、手写提炼摘要、分类打标,再苦思冥想去和历史笔记建立双向链接。当资料只有几十篇时,这种纯手工打理尚能勉强维持;一旦素材累积到数百上千篇,日常梳理、打标和构建 Wiki 的工作量就会演变成一份沉重的全职体力活。大部分人根本没有如此充沛的业余精力,系统最终不可避免地走向断更停摆。 -
孤立碎片与检索断层:看不清脉络,更不知如何调用
传统笔记的检索主要依赖关键词或全文搜索。随着笔记体量膨胀,不仅经常搜不到想找的观点;更致命的是,每一篇笔记都是孤立的碎片。无法看清知识之间的交叉逻辑与演进脉络,面对新的命题或实际问题时,根本不知道如何调用这堆沉睡的资料。每次都需要从头重新消化,既有的积累无法像复利一样自动串联并形成体系。
问题显而易见:不是不够自律,而是直接囤积原始素材、全靠人工去充当“检索器”、“打标工”与“整理工”,在信息爆炸时代注定无法运转。
二、 破局之道:Andrej Karpathy 的 LLM-Wiki 范式#
如何破除传统笔记的维护过载?
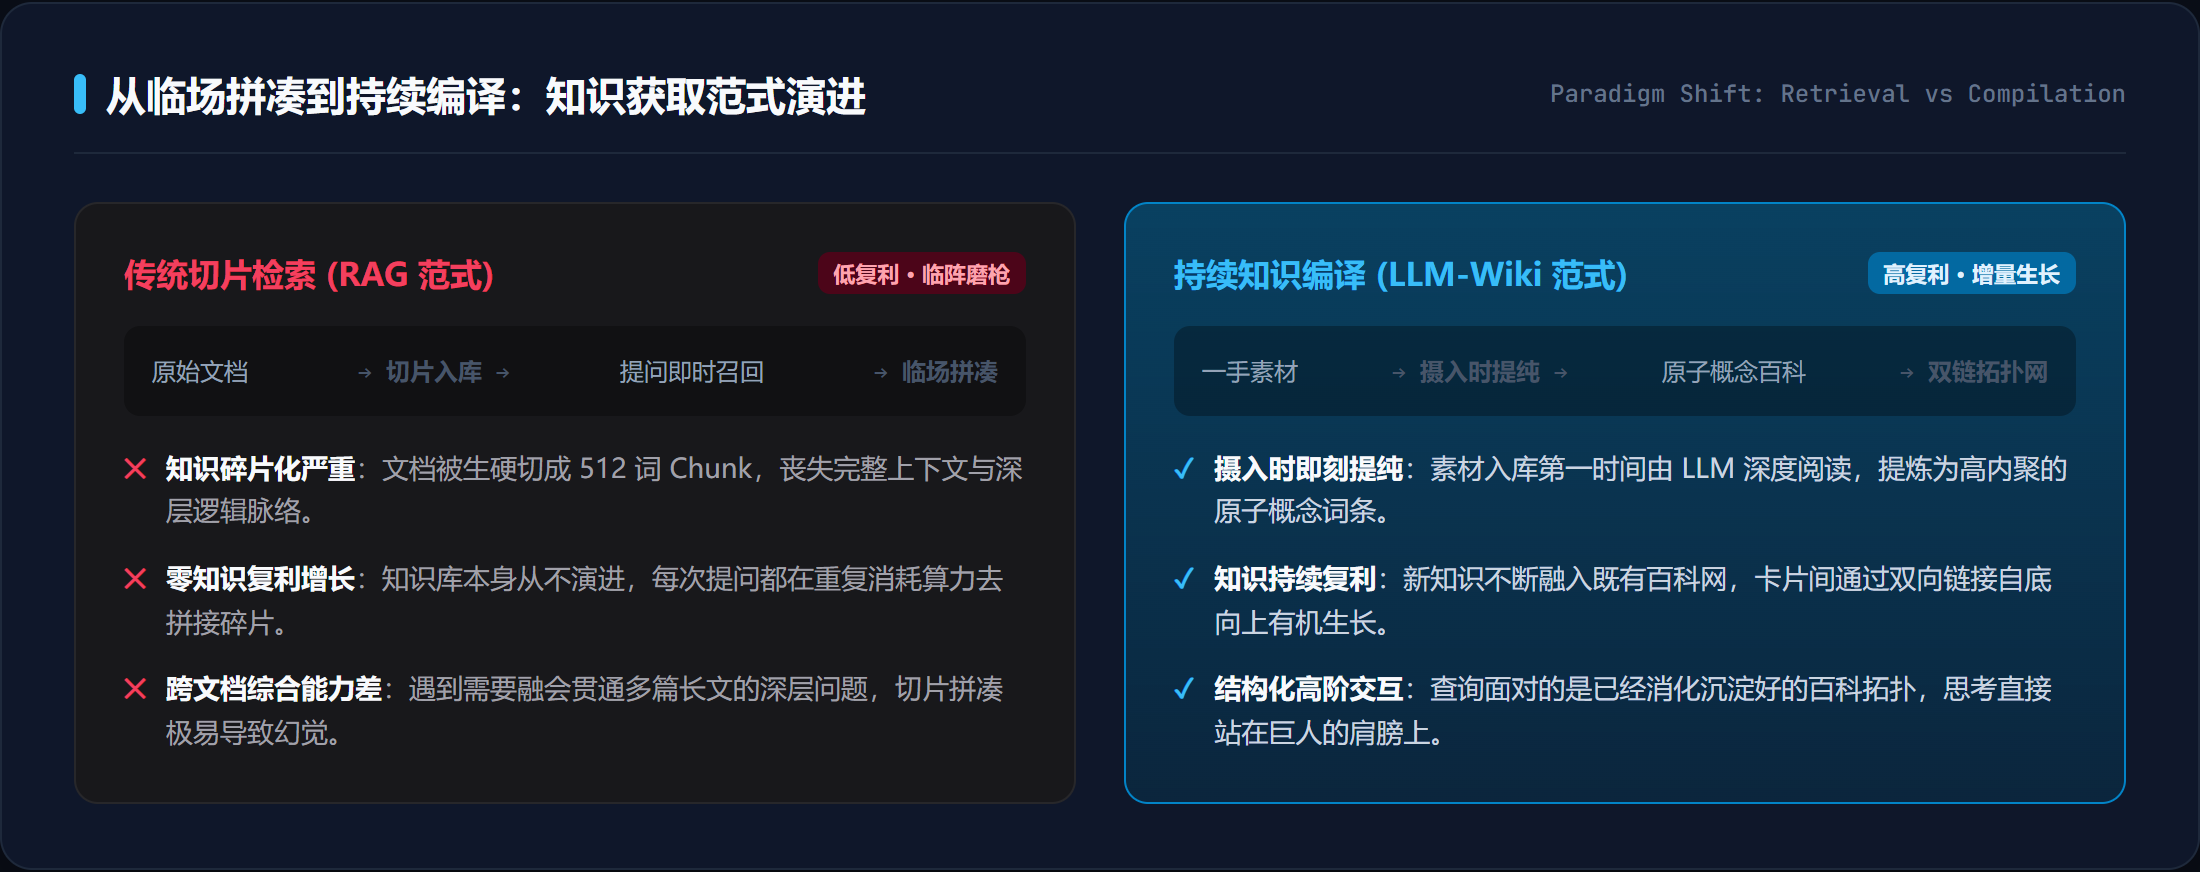
2026 年初,前 OpenAI 联合创始人、前特斯拉 AI 总监 Andrej Karpathy 在其公开构想中提出了 LLM-Wiki 的理念。他尖锐地指出了传统 RAG 与纯手工笔记的致命短板:
“大多数人使用大模型处理文档的方式是 RAG……但这完全没有积累。遇到一个需要综合五篇文档的深层问题,大模型每次都必须临时找出碎片重新拼凑。没有任何东西被沉淀下来。”
为此,Karpathy 提出了一个由大模型全权接管的“自治 Wiki”设想:
“我有一个约 100 篇文章、40 万词的 Wiki,由一个 LLM 全职维护。我很少直接碰这个 Wiki,LLM 是它的全职管理员。”
在他看来,这套体系的本质就像一个持续运转的知识编译器:外部碎片是源码,LLM 是编译器,Wiki 词条就是编译产出的目标知识。这种范式带来了两大颠覆性的转变:
- 编译优先于即时检索(Compile-over-Retrieval)
不再等需要回答问题时才去向量数据库里临时抓取切片(Top-K chunk),而是在素材进入知识库的第一时间,就调用大模型进行深度阅读与概念提纯。知识库的内容不是静态碎片,而是由 LLM 自底向上持续增量编译出的高连通度百科词条。 - 人机权责的彻底重构
人不再充当繁重的笔记收发员与打标工,而是转变为纯粹的素材提供者、最终决策者与提问观察者;大模型则充当 7×24 小时不眠不休的“全职 Wiki 管理员”,负责所有的概念抽象、脉络梳理与构建 Wiki 双链网络。
三、 现实工程的引力:LLM-Wiki 原设想撞上真实规模时的工程摩擦#
Karpathy 的设想描绘了一个极具生命力的自治愿景,但它本质上是一张宏观的设计蓝图。当将这套理念真正投入日常生产环境,面对 500+ 多模态一手素材与 1300+ 篇 Wiki 知识卡片时,理论上的留白与现实中的工程摩擦便不可避免地暴露出来:
LLM-Wiki 理论设想未覆盖的盲区#
- 缺乏强类型规范,大模型自治极易“格式漂移”
原设想让大模型全权维护 Wiki,但没有约定具体卡片的字段标准(Schema)。当大模型自治维护成百上千篇页面时,每次提炼的侧重点、属性键名、标签格式都会产生不可预测的随机漂移。 - 原设想的弱关联对账不够健壮,极易诱发对只读底座的破坏
Karpathy 设想依靠 Wiki 内部的反向引用来判定素材处理状态(Zero-Ledger 零外置账本)。但在真实场景下,这种依赖标题或文件名的弱关联其实并不健壮。一旦素材改名或路径微调就会失效。在实践初期,为了省事很容易踩入一个工程陷阱:倾向于向原始素材文件(Frontmatter)直接回写ingested: true等状态标记。但这彻底违背了 Karpathy 原教旨,直接破坏了“输入底座只读不可变”的物理铁律,随着多端工具流转带来严重的元数据污染。 - 缺乏版本演进与认知冲突的处理标准
当新录入的素材观点与既有词条发生冲突时,大模型在自治合并时往往会粗暴地“覆盖旧认知”或“前后矛盾杂糅”。原理论并未定义在遭遇学术争议或对立流派时,该如何规范保留观点演进与认知张力。
真实知识库项目必然遭遇的工程摩擦#
- 低信噪素材缺乏物理隔离,反复产生处理噪音
在多渠道自动化采集中,输入流难免掺杂低价值推销、琐碎水文或残缺信息。既不想消耗 Token 为其建立卡片,但若没有统一的物理隔离机制,扫描轮询又会反复把它们当作“新素材”拉出来处理,造成持续的流转打扰。 - 规模膨胀下的全库比对性能急剧恶化
原设想假设整个 Wiki 体量较小(百余篇)。但当卡片突破上千篇时,单纯依赖全量文本扫描或跨目录模糊匹配,机器磁盘 I/O 迅速飙升,一次增量比对就要耗费数分钟,日常流转近乎瘫痪。 - 消费与沉淀混杂,纯净知识网被半成品稀释
在基于知识库写文章、做调研或方案比对时,往往会随手在知识库目录里新建草稿或临时笔记。久而久之,纯净的概念百科与一手信源被大量下游创作的半成品草稿稀释污染,知识库拓扑结构迅速退化。
面对上述问题,显然不能只靠大模型自由发挥:LLM-Wiki 指明了“自治编译”的方向,但唯有配合一套严谨的工程标准与物理边界约束,这套体系才能在真实规模下长久运转。
四、 引入 OKF 标准:给第二脑套上工业级规范#
要让大模型在自治维护时保持长期的秩序,仅靠高层设想显然不够。在工程落地中,我选择将 Karpathy 的 LLM-Wiki 设想与 Google Cloud 开源提出的 OKF(Open Knowledge Format,开放知识格式)标准结合使用。
OKF 是 Google 面向 AI 时代知识工程推出的一套开放知识协议。它的核心主张是:大模型绝不能在非结构化的黑盒中随意涂抹知识,面向 Agent 的知识库必须具备像现代代码工程一样的强类型约束(Schema)与拓扑契约。
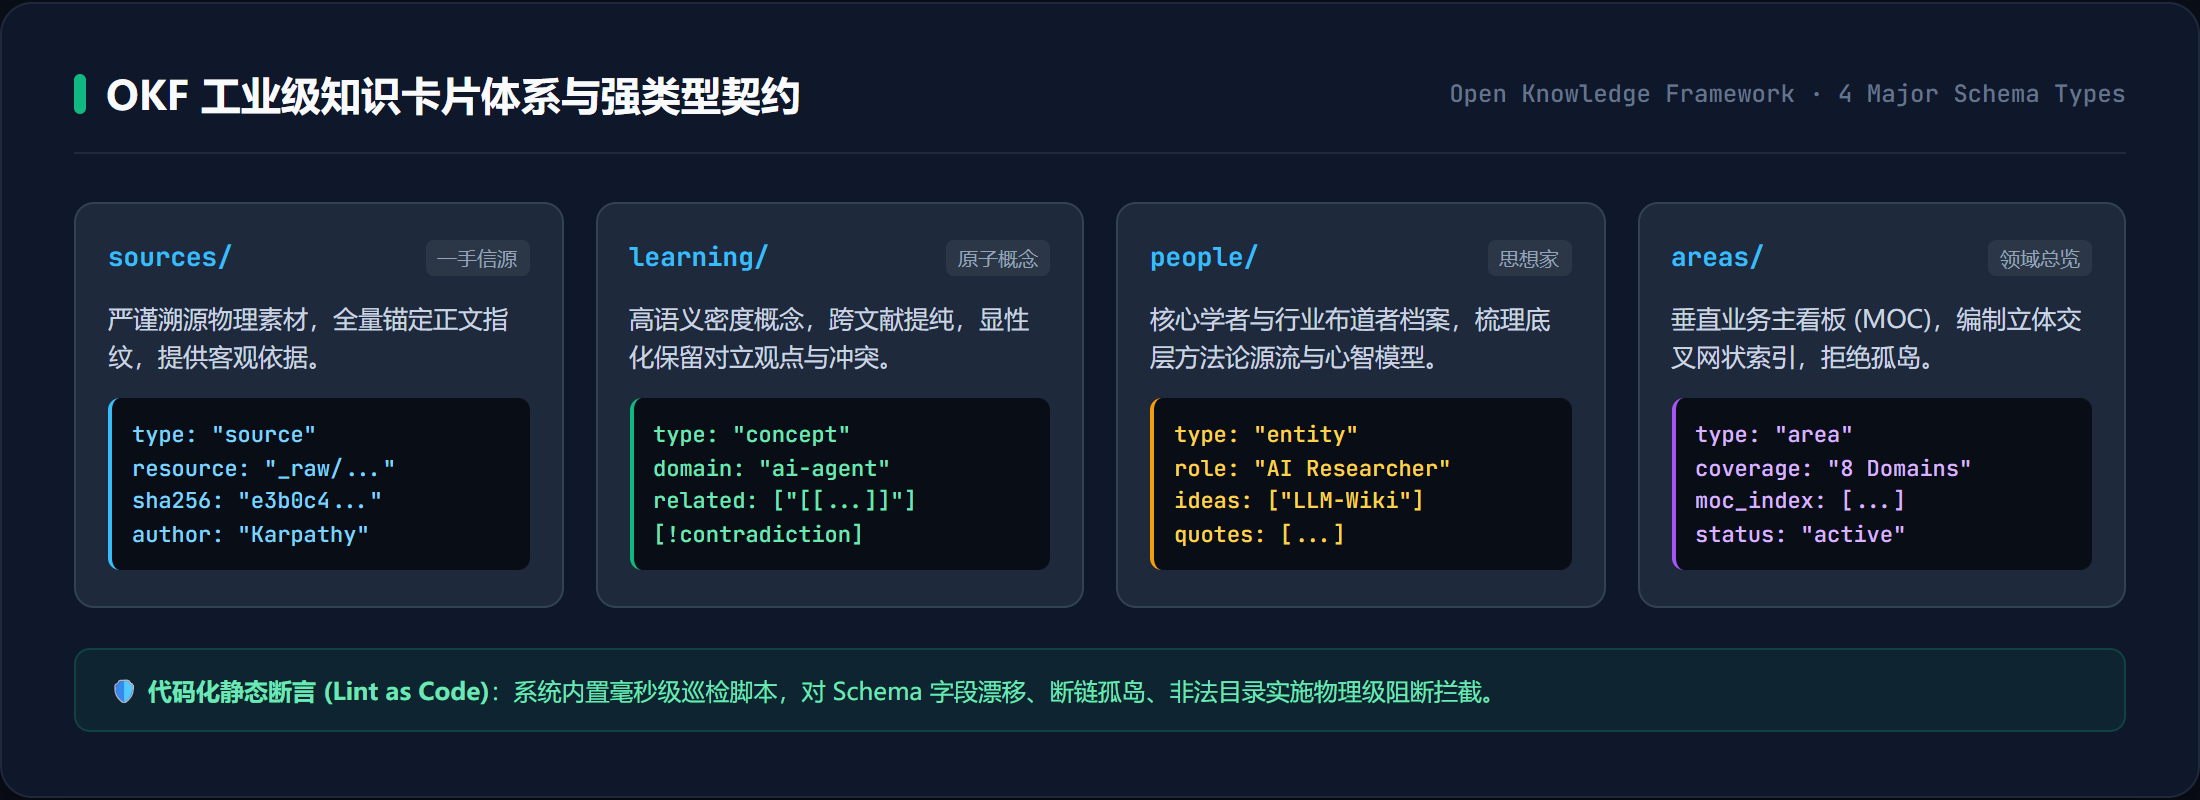
将两者在项目中深度结合,恰好弥补了彼此的短板:LLM-Wiki 提供了持续自治编译的动态机制,而 OKF 则为大模型的日常操作划定了严密的工业级边界:
- 强类型字段与元数据契约(Schema Enforcement)
OKF 严格规范了知识库中不同类型卡片的元数据标准。强类型约束彻底杜绝了大模型的随意发挥,使成百上千个页面的结构整齐划一:- 一手信源(
sources/):规范记录来源标题、采集渠道、原始发布信息与物理溯源凭据。 - 原子概念(
learning/):提取高语义密度的通用规律与方法论。 - 思想家档案(
people/):梳理方法论源流与心智模型。 - 领域总览(
areas/):作为核心业务领域的索引中枢(MOC)。
- 一手信源(
- 显性化保留认知冲突(Contradiction Preservation)
传统方案在大模型消化新材料时,极易静默覆盖历史共识。OKF 契约规定,当新素材观点与既有词条背离时,严禁粗暴覆盖,而是使用醒目的规范标注(如[!contradiction])并行列出对立溯源证据,完整保留认知迭代的张力。 - 工程落地:代码化巡检与系统自愈(Lint as Code)
OKF 虽是元数据规范,但在实际工程落地中,可以将其契约固化为本地自动化的代码级巡检引擎。通过毫秒级的静态规则扫描,自动捕捉断链孤岛、悬空引用与格式漂移,让知识库在代码断言的守护下具备自我修复与抵御熵增的能力。
五、 Ghost 的系统设计思路与实现架构#
基于上述探索,我构建并持续演进了一套属于自己的现代化个人第二脑系统:Ghost(取自我非常喜欢的一部经典动漫作品《攻壳机动队》,Ghost in the Shell)。
Ghost 的核心定位不是一个被动的检索工具,而是一座“以纯文本为物理底座、由大模型全权编译演进、由自己主导价值消费”的外部数字大脑。
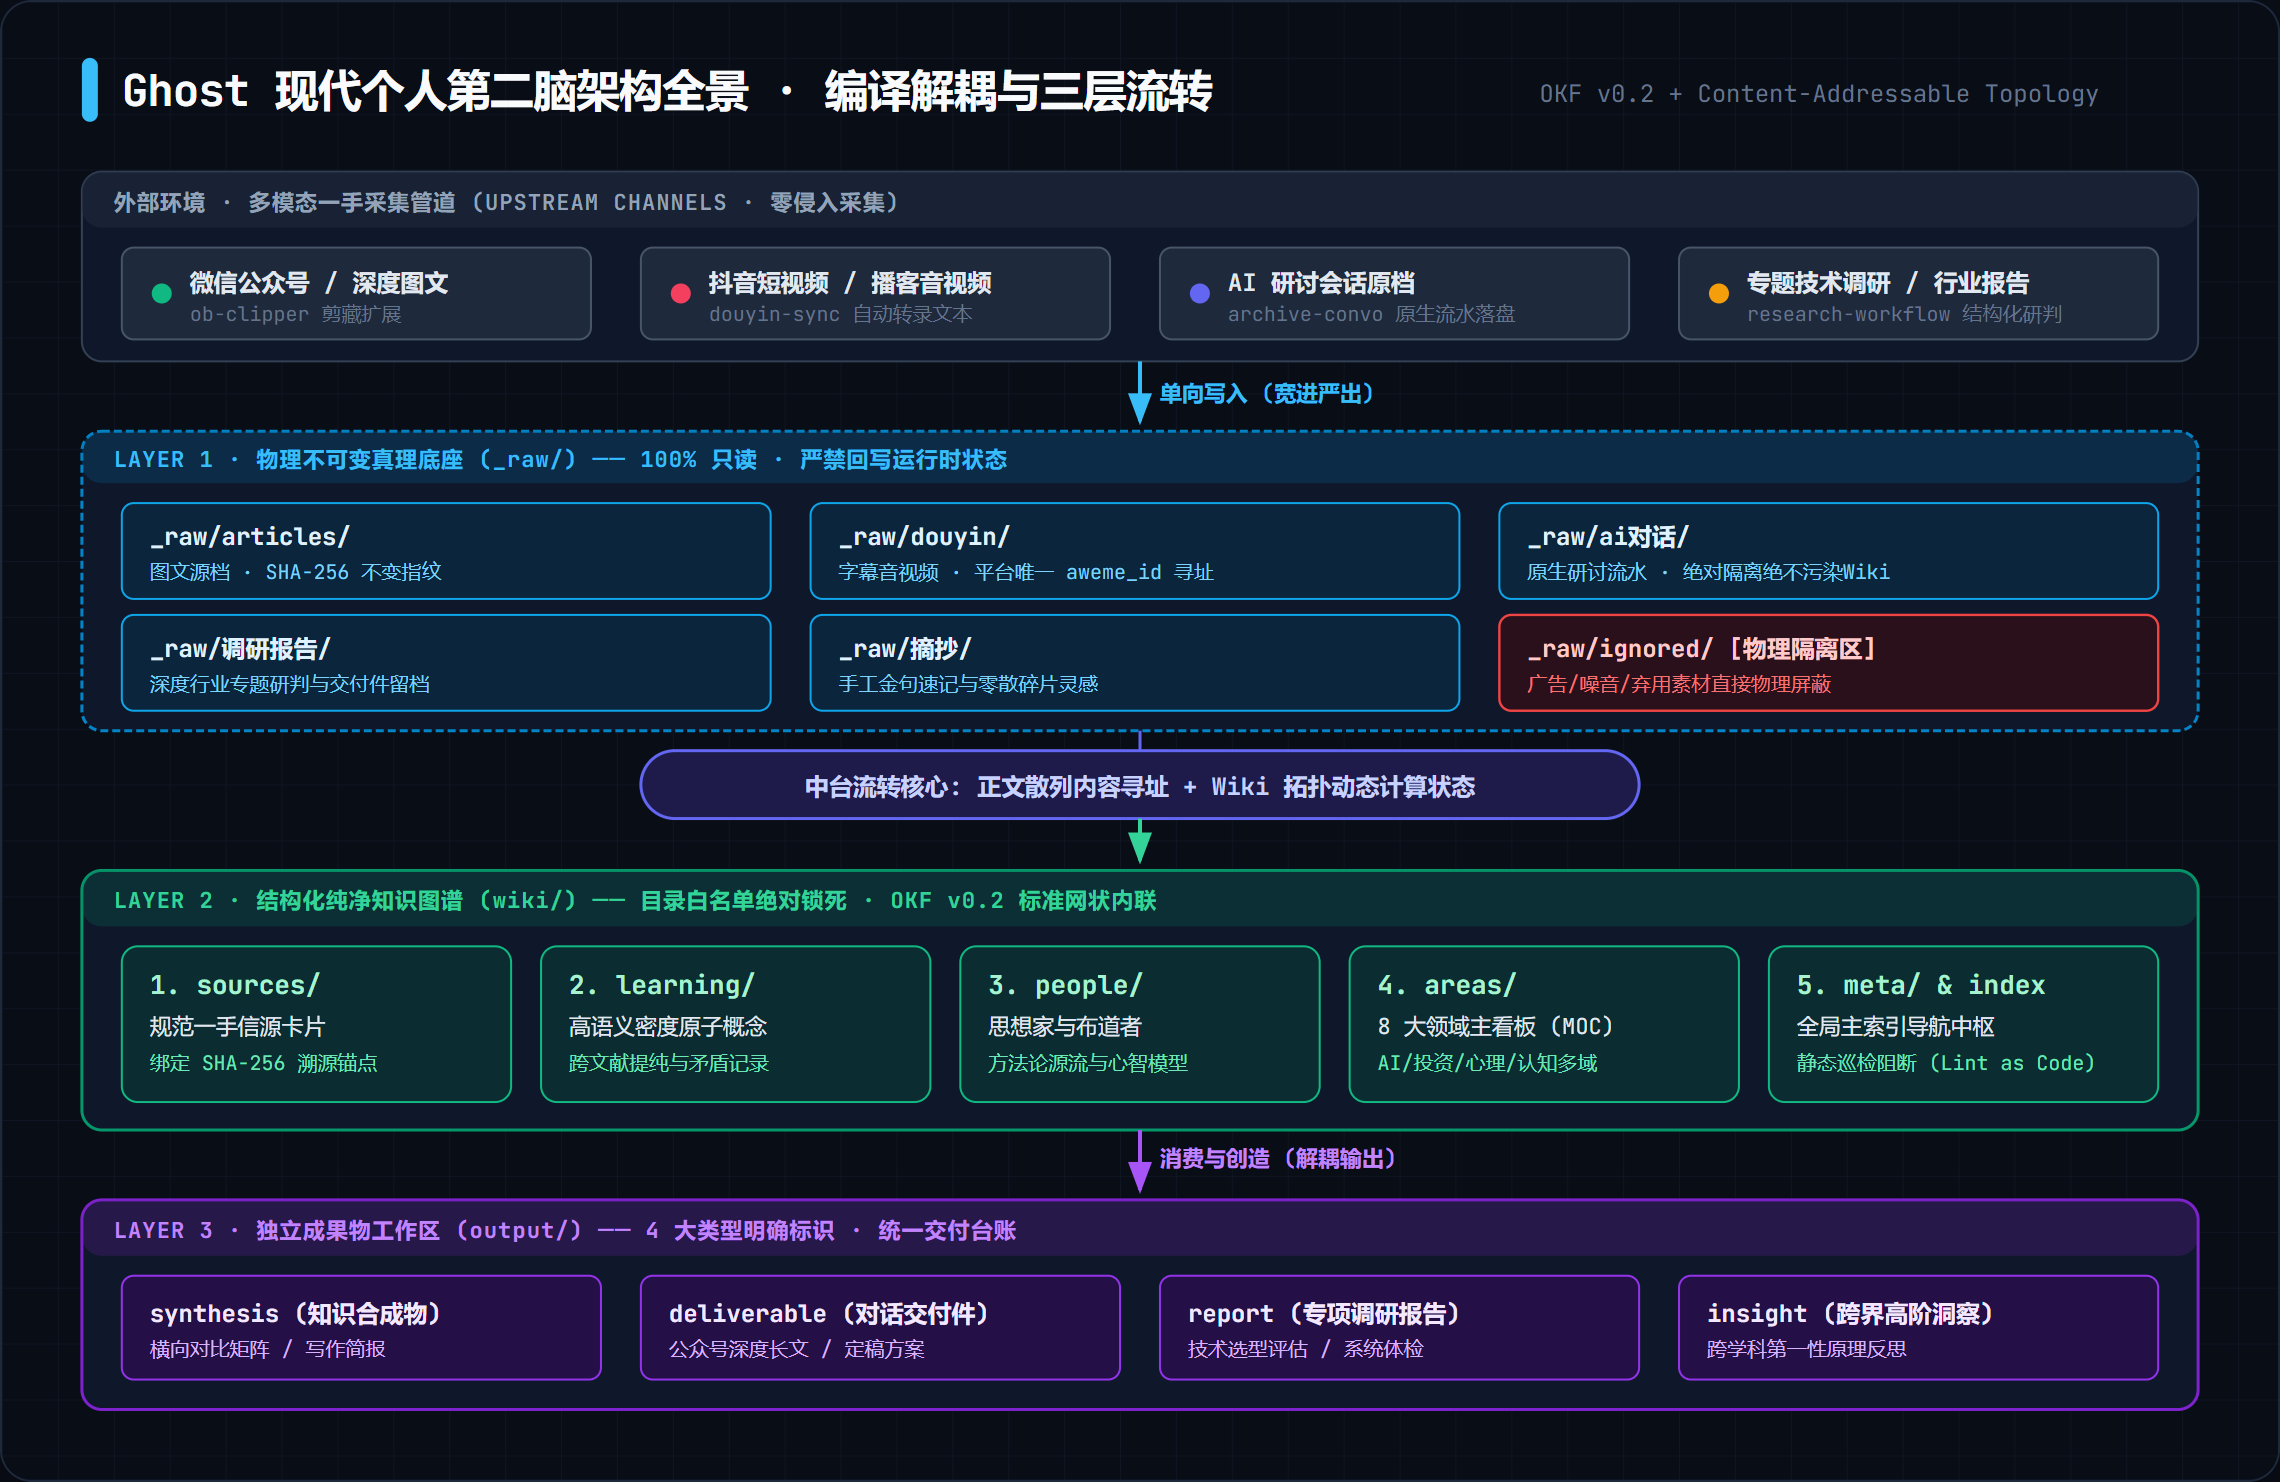
整个系统依托三层解耦与流转架构稳定运行:
Layer 1 · 物理真理底座(_raw/):宽进、只读与物理隔离#
- 绝对只读不可变:外部多模态与图文素材入库即冻结。严禁任何大模型或下游处理脚本修改原始素材正文,更严禁为了标记处理状态而破坏原始文件。
- 物理隔离区(
_raw/ignored/):对于广告、推销或决定放弃炼化的噪音素材,直接物理隔离存放。中台扫描引擎自动忽略该目录,彻底杜绝无用素材反复打扰。 - 流转枢纽:正文散列寻址与健壮对账:
- 正文散列寻址(SHA-256 不变指纹):在 Karpathy 提出的反向引用基础上,进一步引入正文 SHA-256 散列作为物理资产的不可变身份标识。无论原始文件在本地如何重命名或变更路径,大模型对账与溯源关系始终精准锚定,从根源上杜绝了因为路径变动导致的状态误判;
- 内存哈希拓扑索引(毫秒级对账增强):针对大规模文件场景增强了索引层,直接在内存中建立已编译信源的散列拓扑映射。大模型在做增量提纯判定时,只需比对内存中的哈希指纹,将全库对账从原本遍历文本的数分钟级加速至毫秒级,实现真正丝滑的日常自动化。
Layer 2 · 纯净知识拓扑网(wiki/):目录白名单绝对锁定#
为了防止大模型在多轮交互中擅自新增非规范目录,Ghost 在 wiki/ 根目录实施严格的物理白名单阻断。
核心知识库严格隔离为 5 大纯净支柱(前 4 类为 OKF 核心知识实体,最后一类为系统自运维基础设施):
sources/:规范化一手信源卡片(全量绑定 SHA-256 溯源锚点)。learning/:高语义密度原子概念与通用思维模型。people/:关键思想家与方法论源流档案。areas/:垂直领域总看板(涵盖技术架构、投资商业、认知心理等索引 MOC)。meta/:系统元数据与运行态基础设施(全局导航中枢、自动化编译日志与 Lint 巡检报告)。
任何越界的文件与目录均会被自动化巡检脚本直接阻断,确保核心知识库长期纯净。
Layer 3 · 下游成果物专属工作区(output/):消费与沉淀彻底解耦#
输出是检验知识被真正吸收的唯一标准。 只有当知识能够被随时调动、真正支撑起一次深度思考、一篇技术长文或一个工程方案时,这些沉淀才算真正产生了价值。
为了避免下游半成品稀释或污染纯净的知识网络,Ghost 将所有的分析、草稿与定稿作品统一收敛至 output/<topic>/ 专属成果物工作区,并规范了四大清晰出口:
synthesis(知识合成物):以 Wiki 拓扑为事实源自底向上生成的横向对比矩阵(synthesis-comparison.md)与写作参考简报(synthesis-brief.md)。deliverable(对话交付件):人机深度对话研讨、拍板共识后的定稿成果(如 高质量公众号深度长文 、 工程技术方案说明书 )。report(专项调研报告):具备强时效快照属性的技术选型评估与系统健康体检报告。insight(跨界高阶洞察):跨越学科界限的第一性原理与认知突破手记。
所有产物统一登记至 output/_index.md 交付台账,让每次外部内容输出都有迹可循,真正将知识库转化为高质量创作的强力引擎。
六、 总结:当 LLM-Wiki 遇上工业级工程规范#
单纯依靠传统笔记,再自律的人也会被繁重的打标和构建 Wiki 活活累死;单纯仰仗原教旨的 LLM-Wiki,又极易在真实规模下因为缺少约束而陷入架构腐化的泥潭。
LLM-Wiki 与 OKF 的结合,才真正构成了一个可长久运转的完整闭环:
- LLM-Wiki 赋予了系统持续进化的生命力:它把知识库当成编译器,让大模型自底向上提炼演进,彻底打破了传统 RAG 的碎片化拼接,让知识能够像代码一样增量构建、复利生长;
- OKF 规范赋予了系统坚固的工程骨架:它通过不可变底座契约、强类型 Schema 约束、目录白名单隔离与代码化巡检,为大模型的自治操作划定了坚不可摧的执行边界,避免了规模扩大时的混乱。
搭建这套方案的核心,本质上是把繁重的信息抽象与 Wiki 构建交给大模型,把秩序和边界交给工程规范。底座只读保证了素材的客观真实,规范拓扑保证了知识的纯净有序,专属的 output 工作区则让每一次积累都能落到具体的文章与方案中。当繁琐的打理被系统接管,自己才能真正从信息的搬运工中抽身,专注在深度的思考与持续的价值产出上。